   temp visc
1 85.63 0.27
2 64.48 0.40
3 42.12 0.62
4 76.73 0.31
5 58.18 0.46
6 42.35 0.602 Transformaciones
En este capítulo se muestra cómo una transformación de la variable respuesta o de las covariables puede mejorar el modelo.
Transformaciones para linealizar el modelo
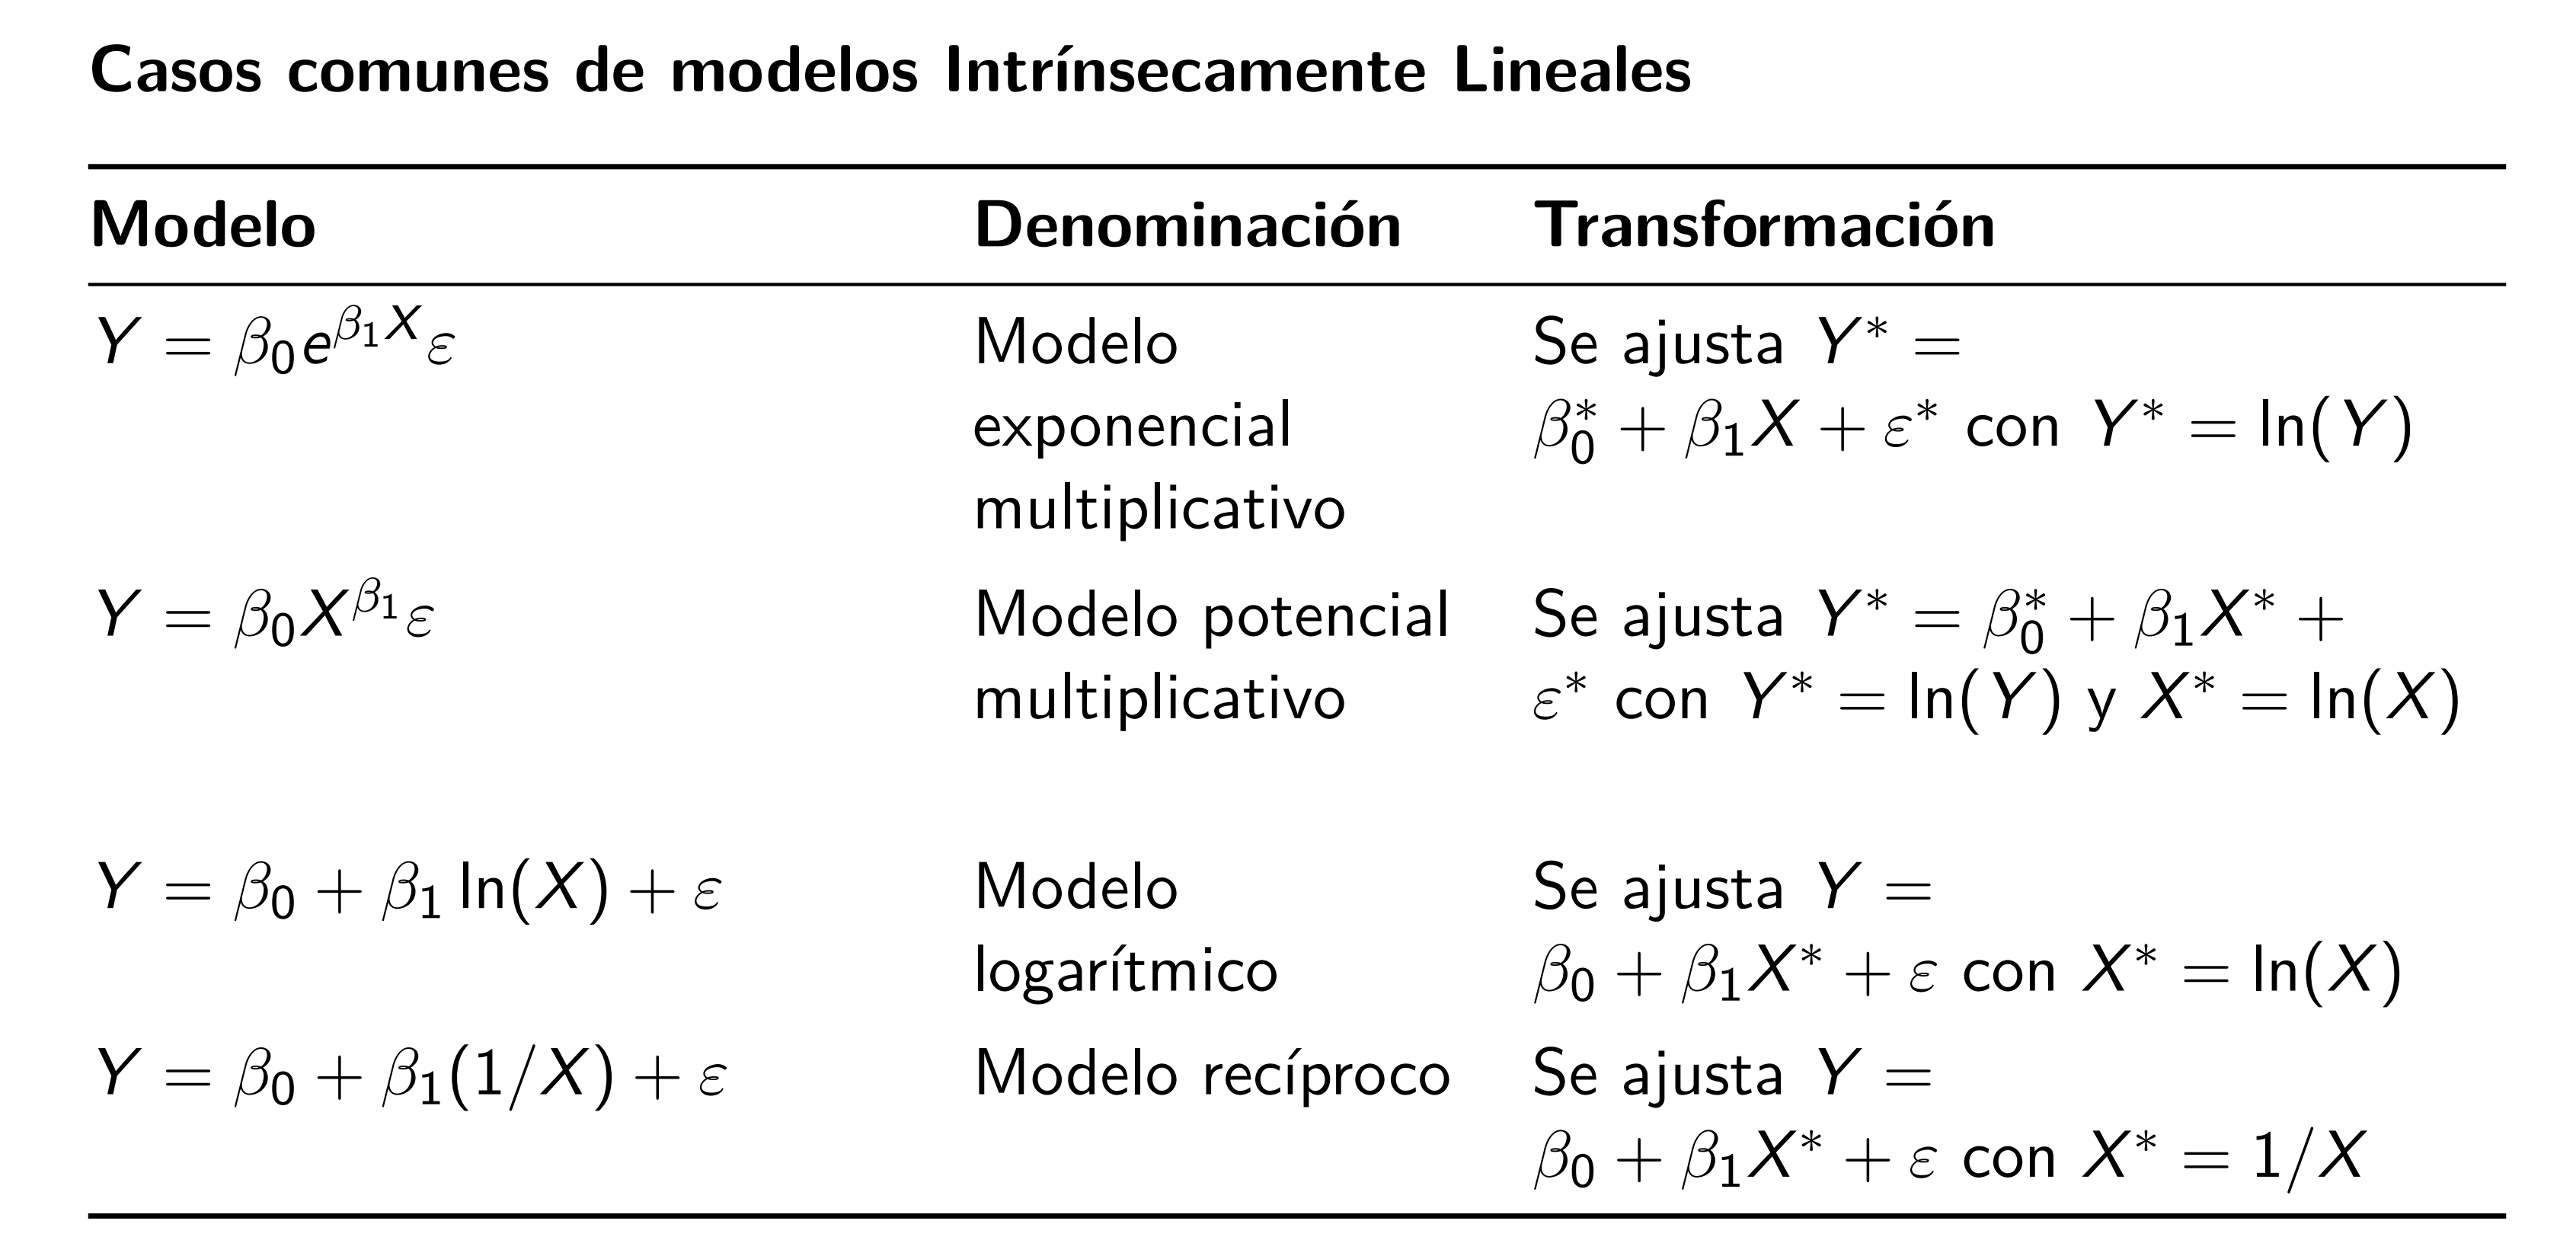
En algunas ocasiones el modelo teórico de los datos tiene una estructura matemática que puede ser linealizable al transformar \(Y\) y/o \(X\). En la siguiente tabla se muestran algunos de los casos en los cuales se puede linealizar el modelo.
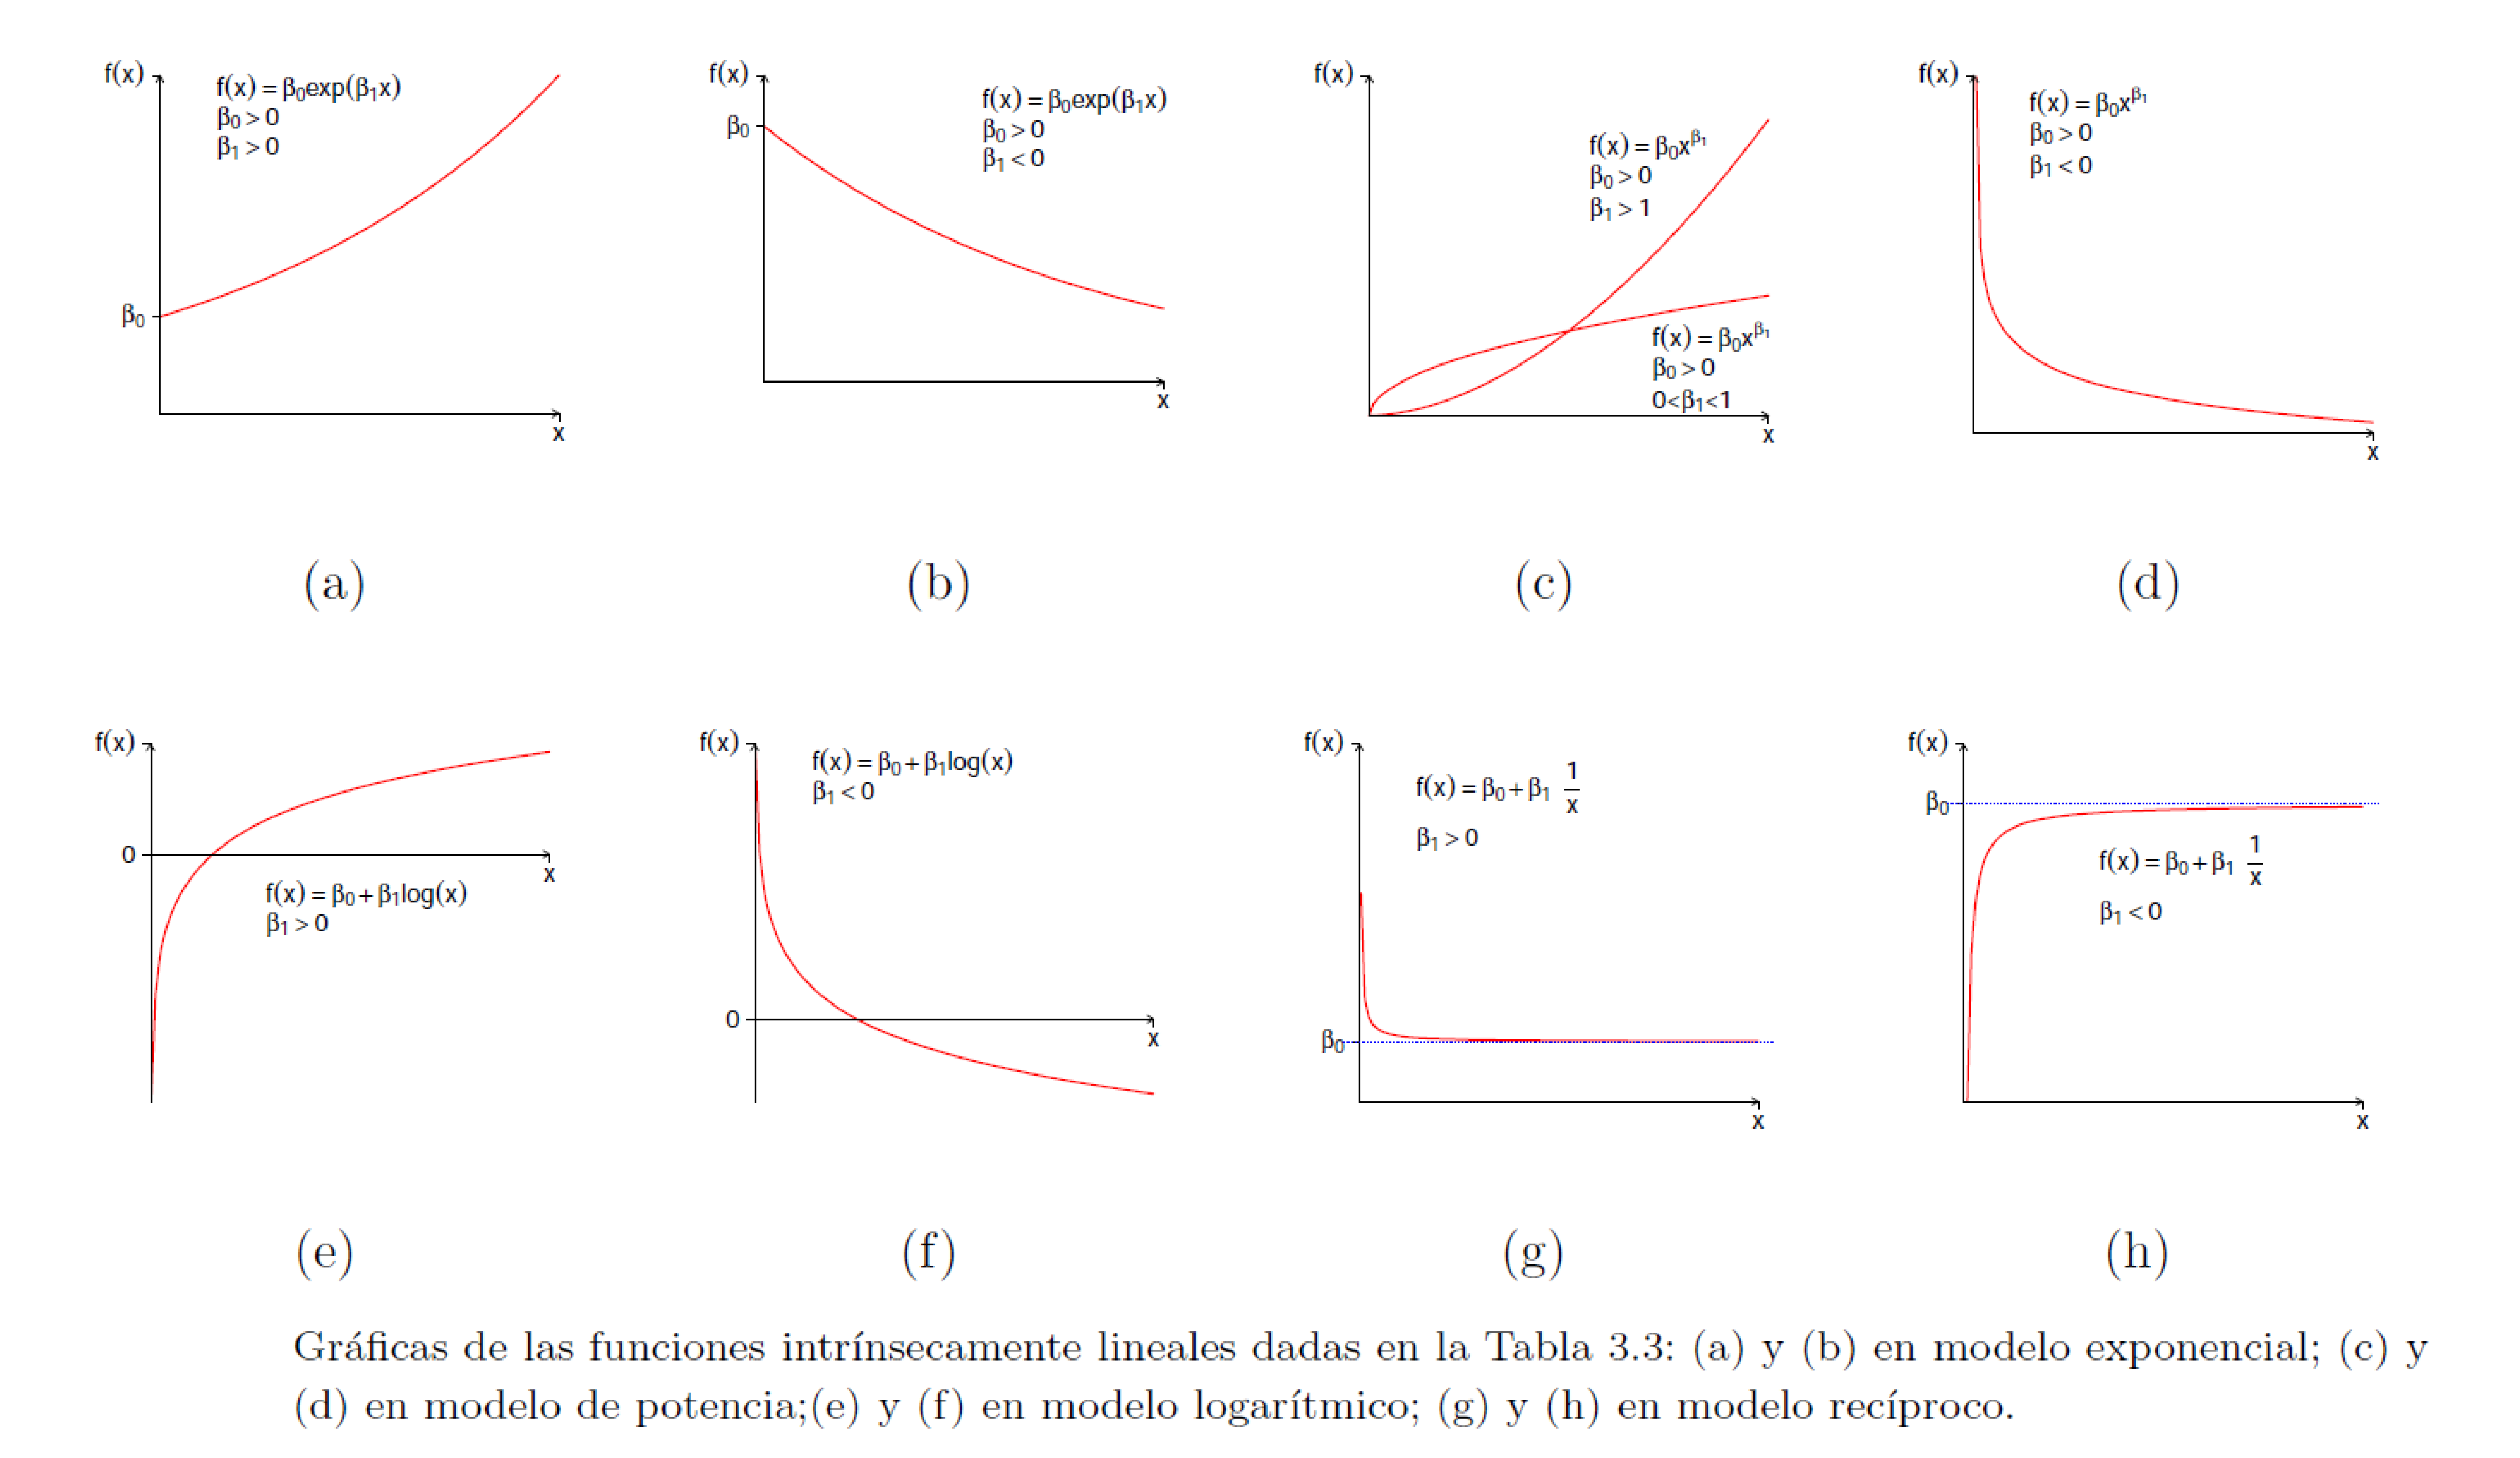
En la siguiente figura se muestran los patrones de los modelos que se pueden linealizar.
Ejemplo
Este ejemplo está basado en el ejericio 5.1 propuesto en el libro Montgomery (2006) se presenta una base de datos de un estudio de cómo influye la temperatura (°C) sobre la viscosidad (mPa s) de las mezclas de tolueno y tetralina. La base de datos cuenta con un total de 50 observaciones, a continuación se muestran las primeras seis observaciones de la base.
- Crear un diagrama de dispersión. ¿Parece apropiado usar una línea recta para modelar los datos?
- Ajuste el modelo de línea recta. Calcule las estadísticas resumidas y las gráficas residuales. ¿Cuáles son sus conclusiones sobre la adecuación del modelo?
- Los principios básicos de la química física sugieren que la viscosidad es una función exponencial de la temperatura. Repita la parte b usando la transformación adecuada según esta información.
- ¿Cuál modelo se debería usar? Escriba la ecuación del modelo.
- Con el modelo elegido, calcule \(\widehat{Visco}\) para \(Temp=0\) y para \(Temp=50\).
Solución
- Diagrama de dispersión
library(ggplot2)
ggplot(datos, aes(x=temp, y=visc)) +
  geom_point() + theme_light() +
  xlim(0, 120) +
  labs(y="Viscocidad (mPa s)", x="Temperatura (°C)")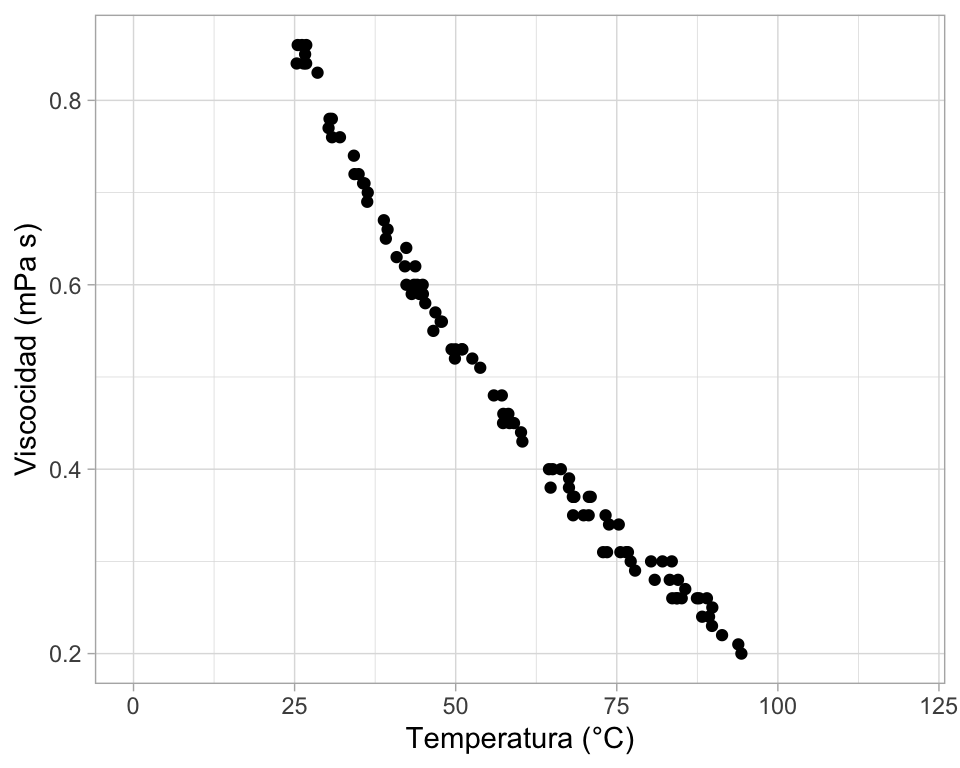
- Ajustando el modelo de línea recta.
m1 <- lm(visc ~ temp, data=datos)Los estadísticos de resumen se obtiene así:
summary(m1)
Call:
lm(formula = visc ~ temp, data = datos)

Residuals:
      Min        1Q    Median        3Q       Max
-0.048849 -0.026135 -0.006075  0.027772  0.079221

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  1.0295982  0.0101903  101.04   <2e-16 ***
temp        -0.0092809  0.0001646  -56.38   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.03356 on 98 degrees of freedom
Multiple R-squared:  0.9701,    Adjusted R-squared:  0.9698
F-statistic:  3179 on 1 and 98 DF,  p-value: < 2.2e-16
De la tabla anterior se observa que:
- La temperatura es significativa porque valor-p es < 2e-16.
- Por cada grado °C en que aumente la temperatura, la viscocidad disminuye en 0.00928098 unidades.
- El \(R^2\) es alto, presenta un valor de 0.9701.
- El modelo m1 es significativo porque valor-p es < 2.2e-16.
Para ver los residuales del modelo se hace lo siguiente:
par(mfrow=c(2, 2))
plot(m1, las=1, col='purple', which=1:3, cex=1.5, pch=19)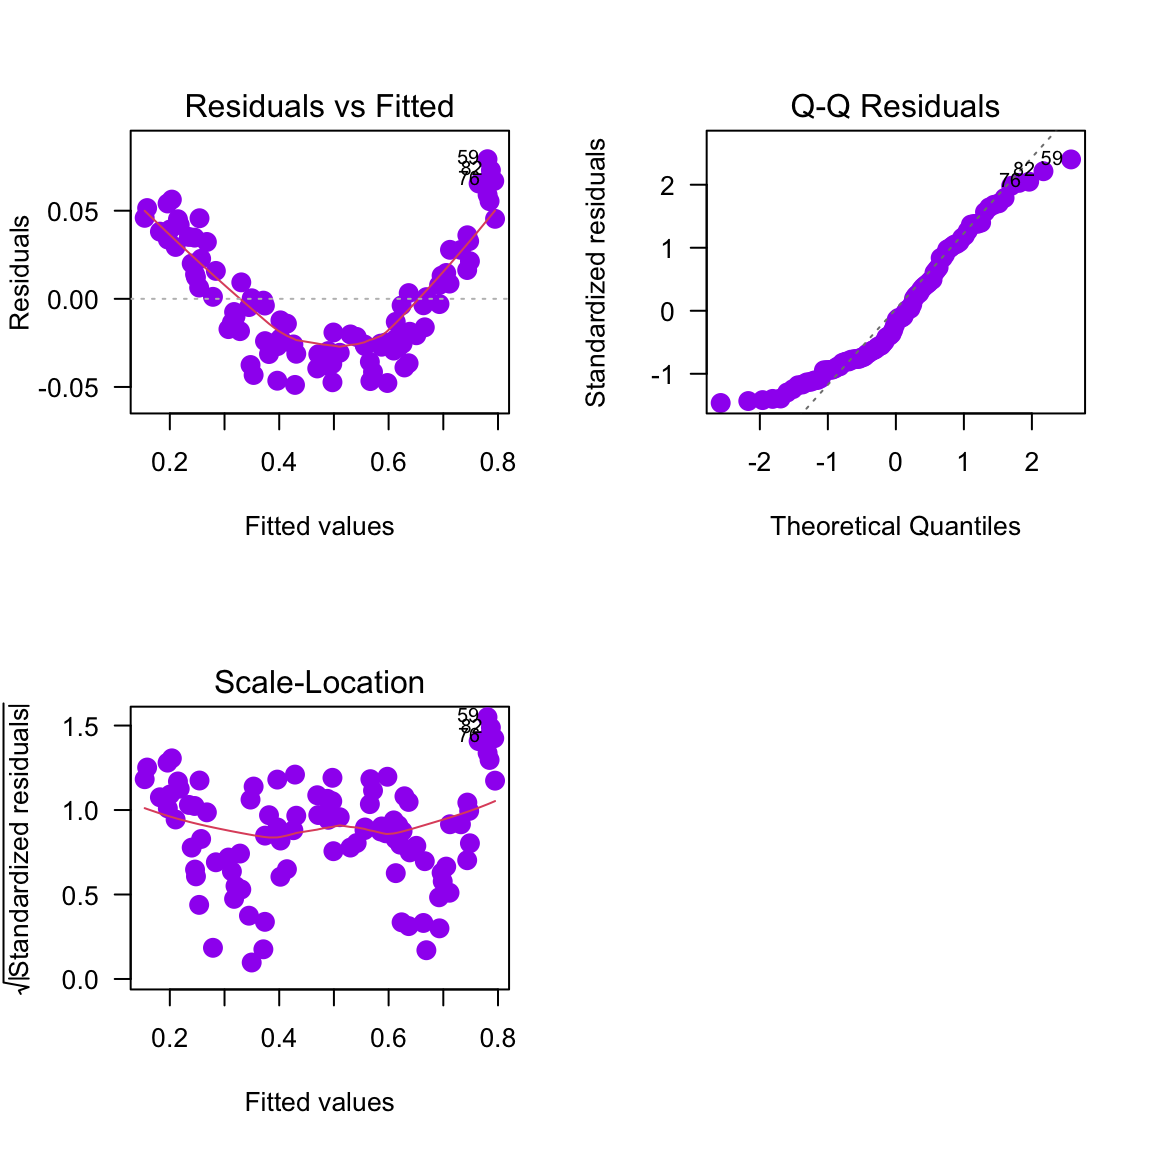
Claramente los residuales muestran un patrón de u, eso indica que hay algo errado con el modelo m1.
res_m1 <- residuals(m1)
shapiro.test(res_m1)
    Shapiro-Wilk normality test

data:  res_m1
W = 0.93894, p-value = 0.0001661- Vamos a entrenar un modelo asumiendo un patrón exponencial multiplicativo \(Y = \beta_0 e^{\beta_1X}\varepsilon\).
Para poder ajustar este modelo en R, es necesario transformar la variable respuesta, es decir, vamos a entrenar con \(Y^*=\log(Y)\). En otras palabras, vamos a aplicar \(\log()\) a ambos lados del modelo exponencial multiplicativo \(Y = \beta_0 e^{\beta_1X}\varepsilon\) y lo que obtiene es:
\[ Y^* = \beta_0^* + \beta_1 X + \varepsilon^*, \]
donde el nuevo intercepto es \(\beta_0^*=\log(\beta_0)\) y el nuevo error es \(\varepsilon^*=\log(\varepsilon)\). El valor de \(\beta_1\) es el mismo en el modelo original y en el modelo transformado.
Warning
Al ajustar el modelo transformado vamos a obtener un intercepto estimado \(\hat{\beta}_0^*\) y una pendiente estimada \(\hat{\beta}_1\).
Si queremos obtener \(\hat{\beta}_0\), debemos despejar de la ecuación \(\beta_0^*=\log(\beta_0)\) el valor de \(\hat{\beta}_0\).
Ajustemos el modelo m2.
m2 <- lm(log(visc) ~ temp, data=datos)Los estadísticos de resumen se obtiene así:
summary(m2)
Call:
lm(formula = log(visc) ~ temp, data = datos)

Residuals:
      Min        1Q    Median        3Q       Max
-0.093451 -0.017099  0.001985  0.017799  0.096605

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  0.3656552  0.0098882   36.98   <2e-16 ***
temp        -0.0199453  0.0001597 -124.87   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.03257 on 98 degrees of freedom
Multiple R-squared:  0.9938,    Adjusted R-squared:  0.9937
F-statistic: 1.559e+04 on 1 and 98 DF,  p-value: < 2.2e-16
De la tabla anterior se observa que:
- La temperatura es significativa porque valor-p es < 2e-16.
- Por cada grado °C en que aumente la temperatura, la log(viscocidad) disminuye en 0.0199453 unidades.
- El \(R^2\) es alto, presenta un valor de 0.9938.
- El modelo m2 es significativo porque valor-p es < 2.2e-16.
Para ver los residuales del modelo se hace lo siguiente:
par(mfrow=c(2, 2))
plot(m2, las=1, col='palegreen3', which=1:3, cex=1.5, pch=19)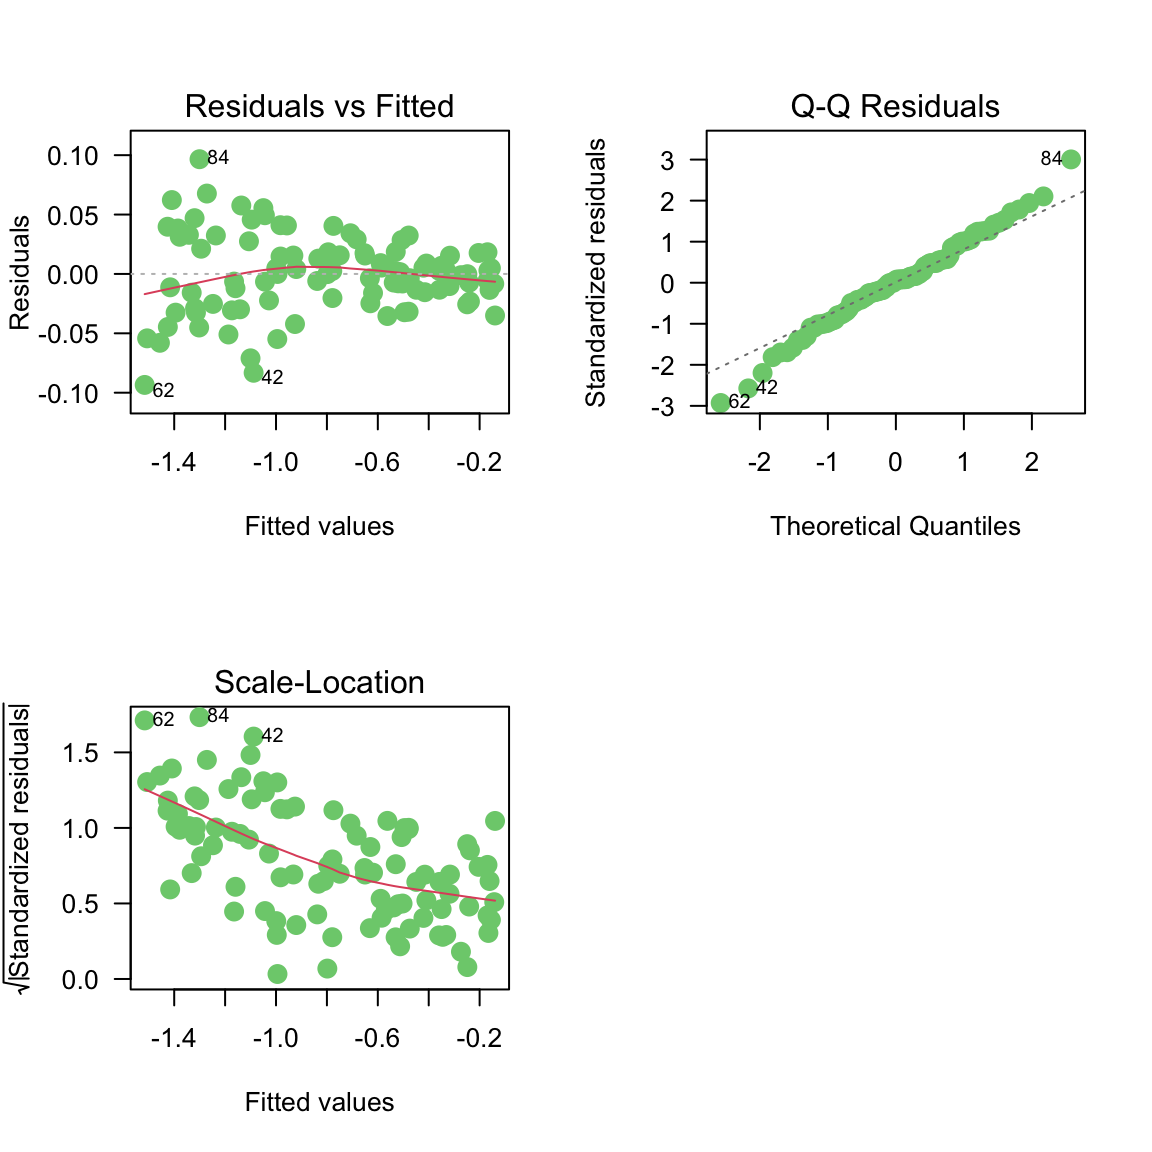
res_m2 <- residuals(m2)
shapiro.test(res_m2)
    Shapiro-Wilk normality test

data:  res_m2
W = 0.99063, p-value = 0.7151
Comparemos las líneas o modejos ajustados m1 y m2 con un diagrama de dispersión.
par(mfrow=c(1, 2))

plot(x=datos$temp, y=datos$visc, pch=20, cex=0.8,
     xlab="Temperatura (°C)", ylab="Viscocidad", main="M1")
abline(m1, col="purple", lwd=2)

plot(x=datos$temp, y=log(datos$visc), pch=20, cex=0.8,
     xlab="Temperatura (°C)", ylab="log(Viscocidad)", main="M2")
abline(m2, col="palegreen3", lwd=2)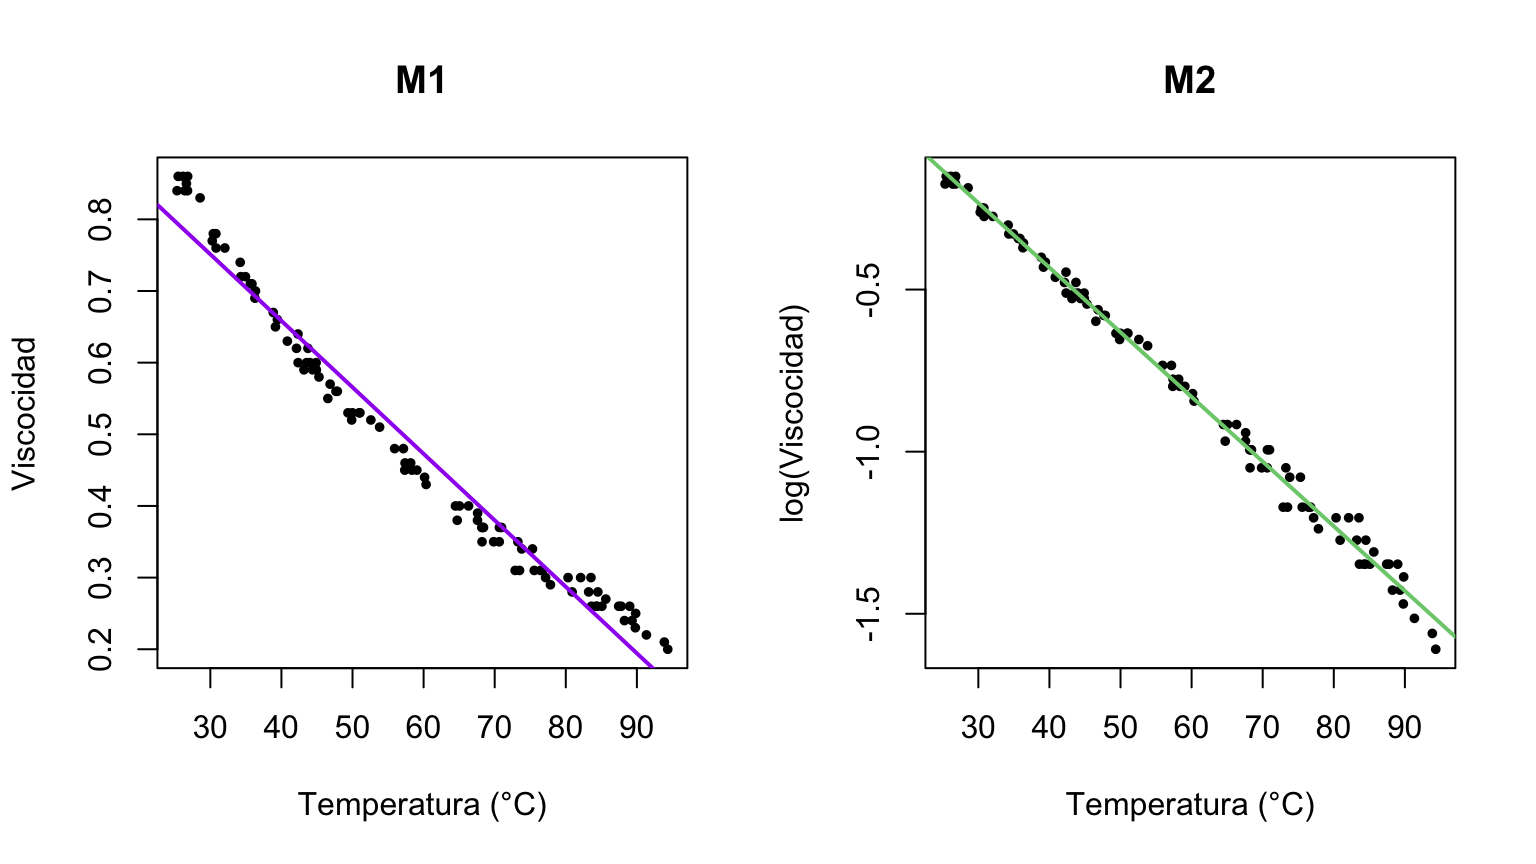
- ¿Cuál modelo se debería usar? Escriba la ecuación del modelo.
Usando los resultados de summary de m2 es posible escribir la ecuación ajustada para el modelo modelo transformado y para el modelo exponencial multiplicativo.
Modelo transformado:
\[ \widehat{Visco^*} = \widehat{\log(Visco)} = 0.3657 - 0.0199 \, Temp, \]
Modelo exponencial multiplicativo:
\[ \widehat{Visco} = 1.4415 \, e^{- 0.0199 \, Temp}, \]
donde \(1.4415=\exp(0.3657)\).
- Con el modelo elegido, calcule \(\widehat{Visco}\) para \(Temp=0\) y para \(Temp=50\).
- La cantidad \(\widehat{Visco} \vert Temp=0\) no se debe calcular.
- La cantidad \(\widehat{Visco} \vert Temp=50\) es \(1.4415 \, e^{- 0.0199 \times 50} = 0.5330\).
visco_hat <- function(x) 1.4415 * exp(-0.0199*x)

plot(x=datos$temp, y=datos$visc, pch=20, cex=0.8,
     xlab="Temperatura (°C)", ylab="Viscocidad",
     main="Modelo final")

curve(expr=visco_hat(x), add=TRUE, col="tomato")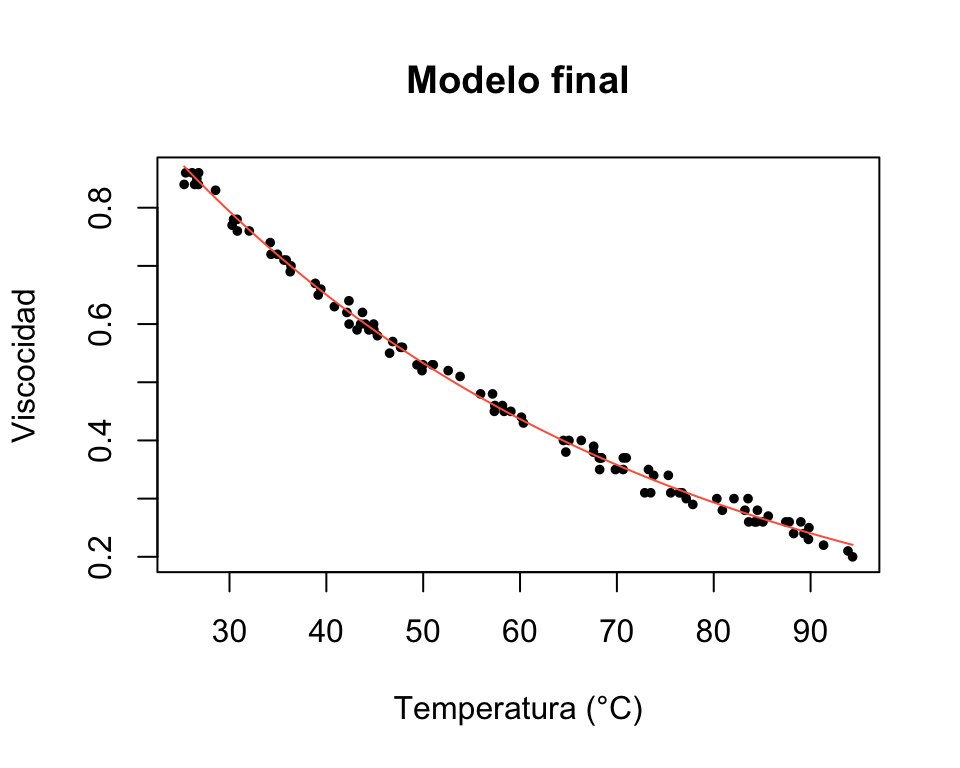
Transformación Box-Cox
En los modelos de regresión lineal múltiple, uno de los supuestos fundamentales sobre los errores aleatorios (\(\epsilon_i\)) es que deben presentar homoscedasticidad (varianza constante) y seguir una distribución normal. Cuando estos supuestos se violan —frecuentemente debido a asimetrías en la variable respuesta o relaciones no lineales entre las variables—, la transformación Box-Cox constituye una de las herramientas más potentes y elegantes para corregirlos.
La familia de transformaciones Box-Cox para una variable respuesta estrictamente positiva \(y > 0\) está definida por una familia de funciones parametrizadas por \(\lambda\):
\[ y^{(\lambda)} = \begin{cases} \frac{y^\lambda - 1}{\lambda \cdot \dot{y}^{\lambda-1}} & \text{si } \lambda \neq 0 \\ \dot{y}\ln(y) & \text{si } \lambda = 0 \end{cases} \]
donde \(\dot{y}\) es la media geométrica que se calcula como \(\dot{y} = \ln^{-1}((1/n) \sum_{i=1}^{n}\ln(y))\).
El objetivo principal es encontrar el valor óptimo de \(\lambda\) que maximice la verosimilitud (log-likelihood) del modelo ajustado, logrando que los residuos se acerquen lo máximo posible a una distribución normal con varianza constante.
Algunos valores comunes de \(\lambda\) y su interpretación práctica son:
- \(\lambda = 1\): Sin transformación (los datos originales ya son adecuados).
- \(\lambda = 0.5\): Transformación de raíz cuadrada (\(\sqrt{y}\)), útil para datos de conteo o varianzas proporcionales a la media.
- \(\lambda = 0\): Transformación logarítmica natural (\(\ln(y)\)), útil para datos con asimetría positiva severa o crecimientos multiplicativos.
- \(\lambda = -1\): Transformación recíproca o inversa (\(1/y\)).
Note
Una recomendación práctica es que si \(\lambda \neq 0\), la transformación sería \(y^{(\lambda)}=y^\lambda\), y si \(\lambda = 0\) la transformación sería \(y^{(\lambda)}=\ln(y)\).
Ejemplo
En este tenemos unos datos a los cuales debemos ajustar un modelo de regresión lineal simple tradicional y luego aplicar la transformación Box-Cox para ajustar un nuevo modelo de regresión lineal simple. Los datos considerar son los siguientes:
datos <- structure(list(x = 10:100,
                        y = c(0.3992, 0.1868, 0.1488, 0.852,
                              0.1565, 0.1482, 0.1797, 0.17, 0.1631, 0.1678, 0.1477, 0.1574,
                              0.145, 0.1225, 0.1064, 0.1187, 0.1221, 0.1257, 0.1208, 0.084,
                              0.1021, 0.1071, 0.104, 0.0929, 0.1024, 0.1091, 0.0871, 0.0995,
                              0.0886, 0.0947, 0.0784, 0.0875, 0.0878, 0.0848, 0.092, 0.0867,
                              0.0933, 0.0851, 0.0773, 0.0771, 0.0673, 0.0783, 0.076, 0.0722,
                              0.0747, 0.0735, 0.0732, 0.073, 0.0688, 0.0679, 0.0727, 0.0667,
                              0.068, 0.0668, 0.063, 0.0601, 0.0566, 0.0631, 0.0557, 0.063,
                              0.0571, 0.0522, 0.0579, 0.0591, 0.0568, 0.0522, 0.0587, 0.0522,
                              0.0519, 0.0536, 0.0538, 0.0544, 0.0538, 0.0512, 0.0483, 0.052,
                              0.0543, 0.0524, 0.0501, 0.0508, 0.0501, 0.0497, 0.0517, 0.049,
                              0.047, 0.0469, 0.0468, 0.048, 0.0474, 0.0487, 0.0465)),
                   class = "data.frame", row.names = c(NA, -91L))

head(datos)
x y
1 10 0.3992
2 11 0.1868
3 12 0.1488
4 13 0.8520
5 14 0.1565
6 15 0.1482Solución
Lo primero que vamos a realizar es crear un diagrama de dispersión para los datos.
with(datos, plot(x=x, y=y, pch=19, col="tomato")) 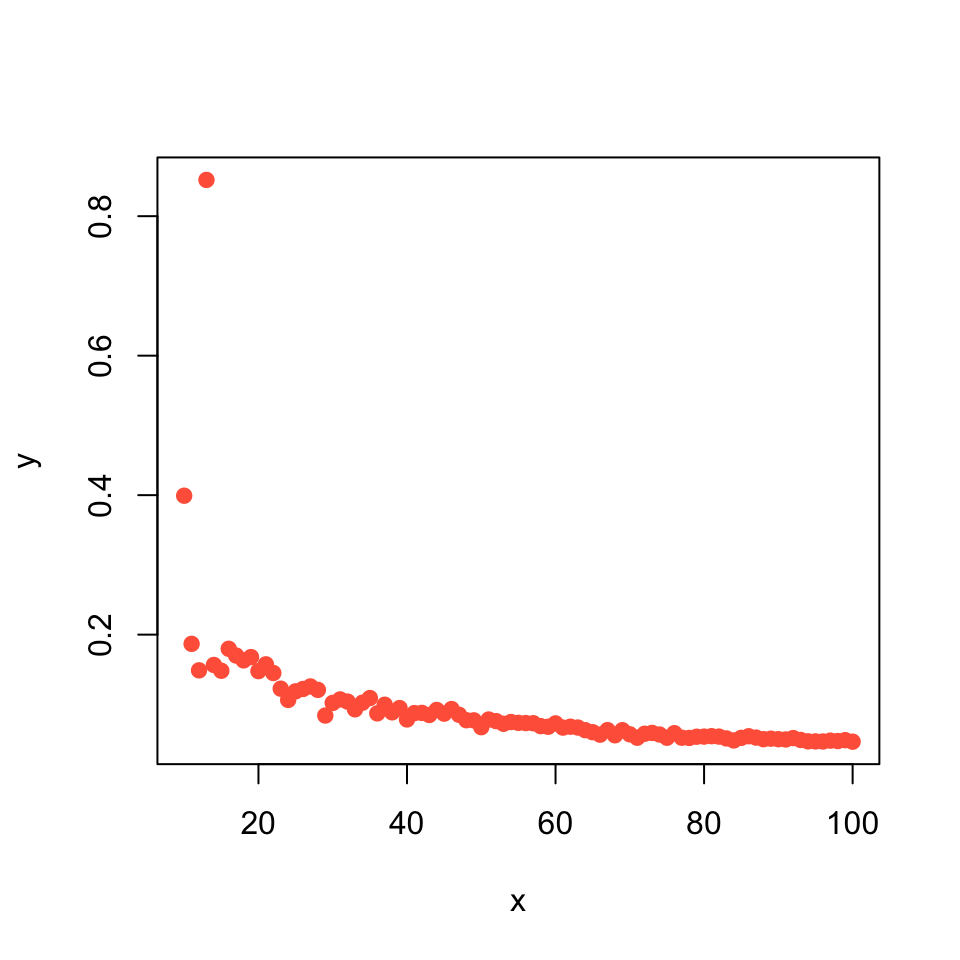
De la figura anterior podemos ver claramente que hay un patrón curvo en la nube de puntos y que la dispersión de los valores de \(Y\) no es constante. Aún así, vamos a ajustar un modelo de regresión lineal simple a los datos.
mod1 <- lm(y ~ x, data=datos)
summary(mod1)
Call:
lm(formula = y ~ x, data = datos)

Residuals:
     Min       1Q   Median       3Q      Max
-0.06102 -0.02693 -0.01396  0.00844  0.67606

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)  0.2010610  0.0193030  10.416  < 2e-16 ***
x           -0.0019324  0.0003167  -6.102 2.67e-08 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.07936 on 89 degrees of freedom
Multiple R-squared:  0.2949,    Adjusted R-squared:  0.287
F-statistic: 37.23 on 1 and 89 DF,  p-value: 2.671e-08
De la tabla resumen anterior vemos que el \(R^2=0.2949\) y muy bajo. Al crear un gráfico de residuales versus los valores ajustados, encontramos lo siguiente:
plot(mod1, which=1, pch=19, col="tomato") # Plotting only residuals vs fitted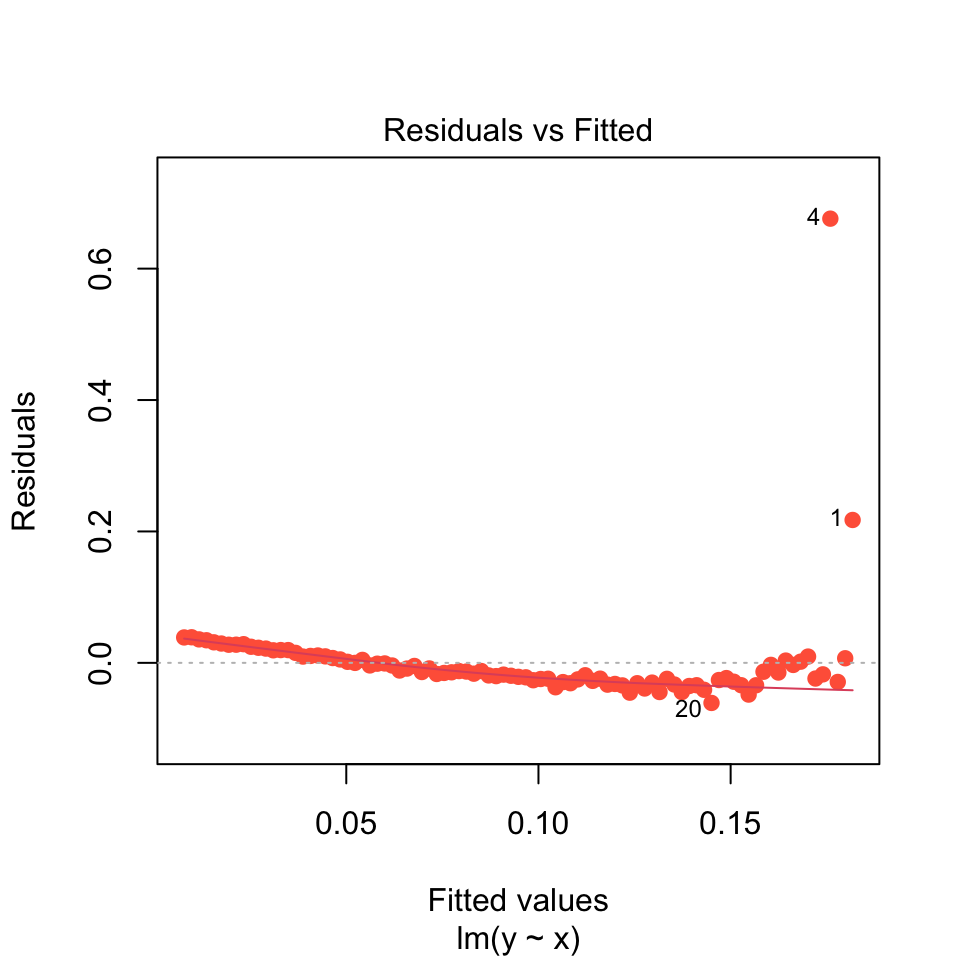
De esta figura se observa un patrón muy pero muy claro, y lo que debió aparecer era una nube de puntos sin ningún patrón, eso significa que muy posiblemente se viola el supuesto de varianza constante de los errores y la relación de linealidad.
Ahora vamos a buscar el valor de \(\lambda\) para realizar la transformación de Box-Cox así:
# Cargamos la librería MASS para poder usar la función boxcox
library(MASS)
bc <- boxcox(mod1)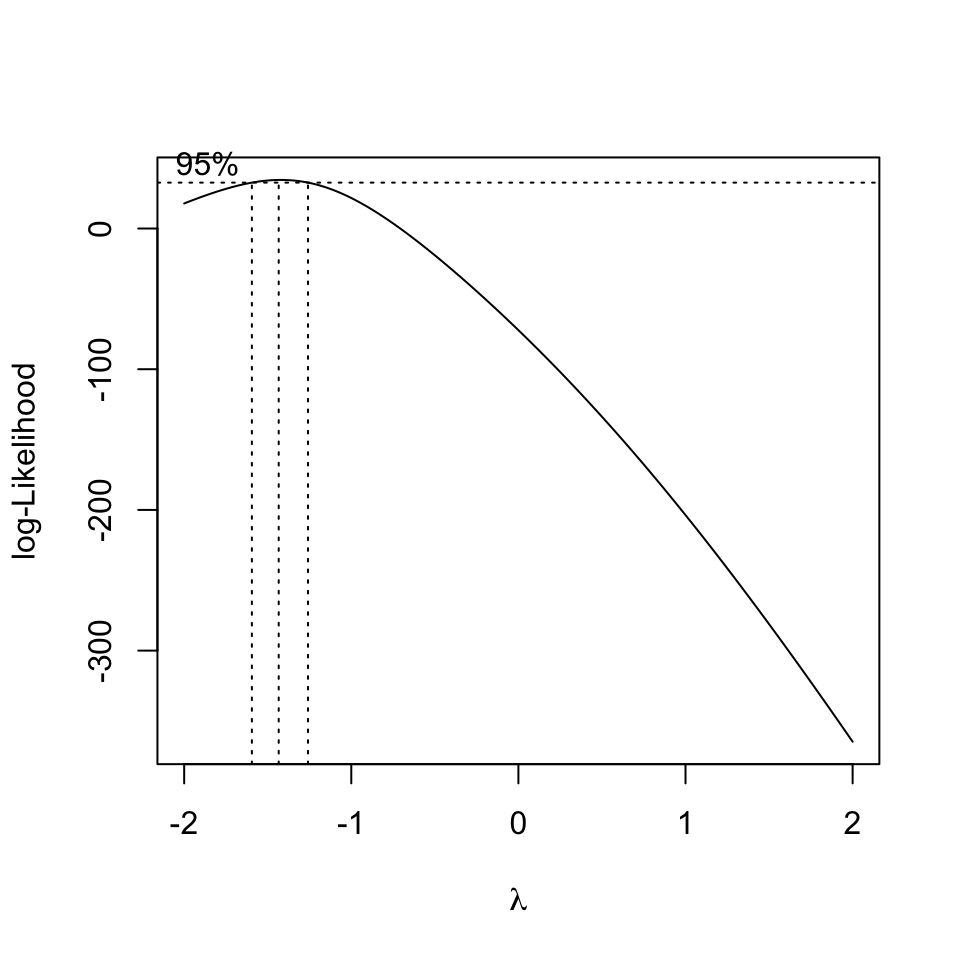
# Para encontrar el valor de lambda que maximiza el log-likelihood hacemos
lambda <- bc$x[which.max(bc$y)]
lambda
[1] -1.434343Como ya conocemos el valor de \(\lambda\), vamos a transformar la variable respuesta original y vamos a crear nuevamente el gráfico de dispersión para los datos transformados.
datos$y_transf <- datos$y^lambda
with(datos, plot(x=x, y=y_transf, pch=19, col="purple")) # Observe que ahora se ve linealidad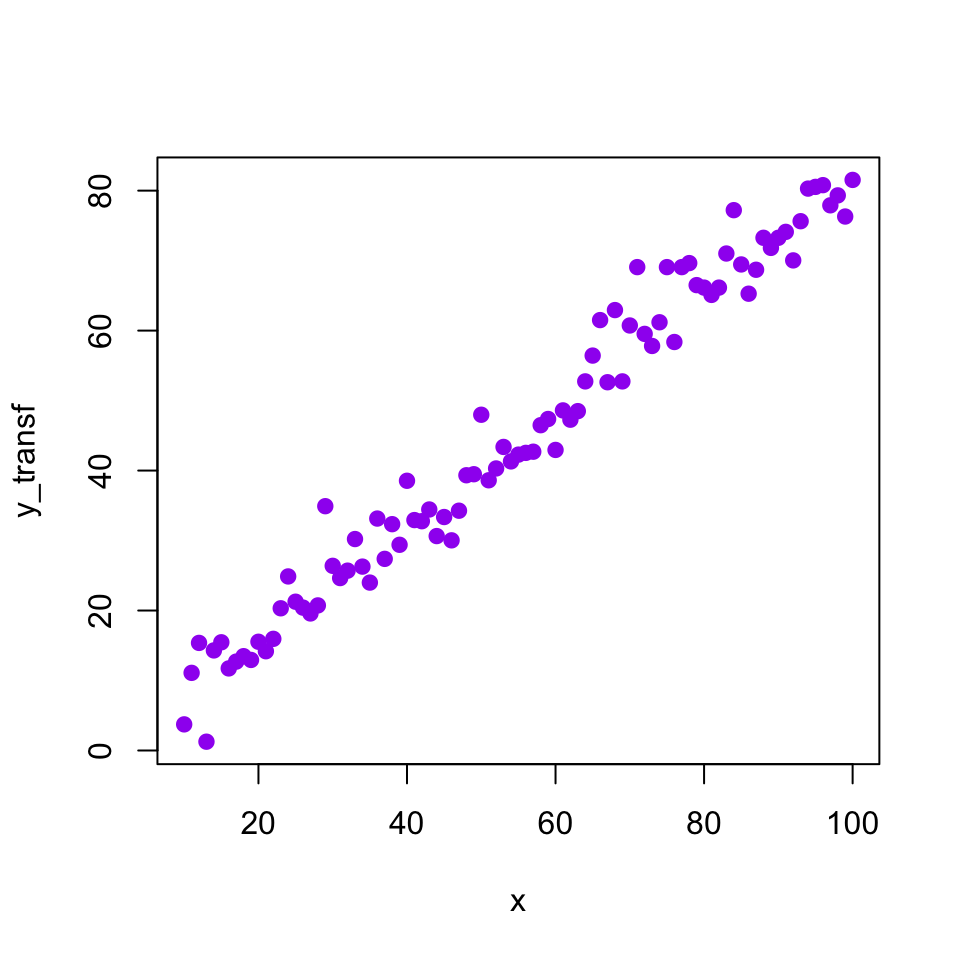
Lo que vemos ahora es que la nube de puntos está alineada y que la varibilidad de los valores de \(y_{transf}\) es constante para cada valor de \(x\). Vamos a ajustar un nuevo modelo a los datos.
mod2 <- lm(y_transf ~ x, data=datos)
summary(mod2)
Call:
lm(formula = y_transf ~ x, data = datos)

Residuals:
    Min      1Q  Median      3Q     Max
-8.8217 -2.4037 -0.7189  2.0704 11.5521

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -0.70849    0.94966  -0.746    0.458
x            0.82988    0.01558  53.263   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.904 on 89 degrees of freedom
Multiple R-squared:  0.9696,    Adjusted R-squared:  0.9692
F-statistic:  2837 on 1 and 89 DF,  p-value: < 2.2e-16
De la tabla resumen anterior vemos que el \(R^2=0.9696\). Al crear un gráfico de residuales versus los valores ajustados, encontramos lo siguiente:
plot(mod2, which=1, pch=19, col="purple") # Plotting only residuals vs fitted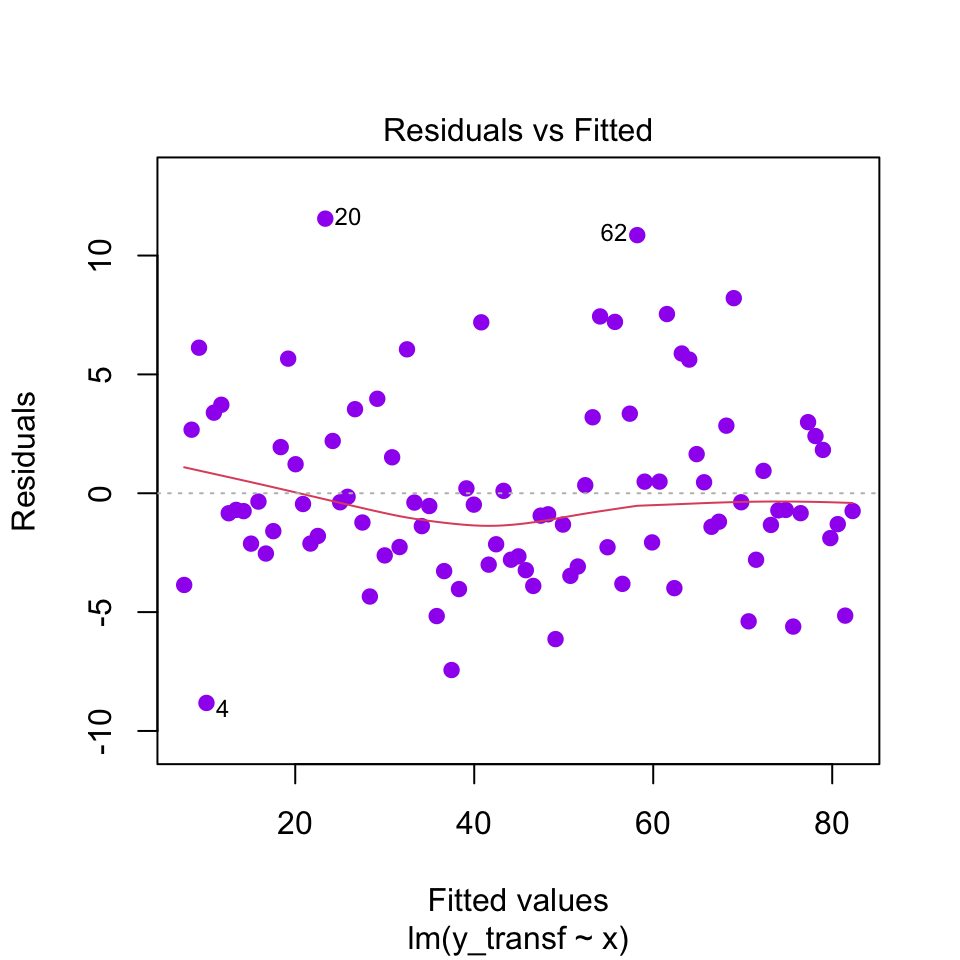
De este gráfico de residuales versus los valores ajustados vemos que no hay un patrón evidente, eso significa que se cumplen los supuestos del modelo de regresión lineal simple.
Usando los resultados de la última tabla de resumen podemos escribir el modelo ajustado así:
\[\begin{align} \hat{y}_{transf} = \hat{y}^{-1.43} &= -0.71 + 0.83 x, \\ \hat{\sigma} &= 3.904 \end{align}\]
o también lo podemos escribir así
\[\begin{align} \hat{y} &= (-0.71 + 0.83 x)^{1/-1.43}, \\ \hat{\sigma} &= 3.904 \end{align}\]